Was die Prüfwerkzeuge nicht sehen
Auf Hunderten Seiten warnte ein Prüfwerkzeug, der Autor eines Beitrags müsse eine Person oder Organisation sein. In jedem Fall war er es – als korrekter Verweis auf das Unternehmen. Wer die Warnung «behoben» hätte, hätte die Daten verschlechtert.
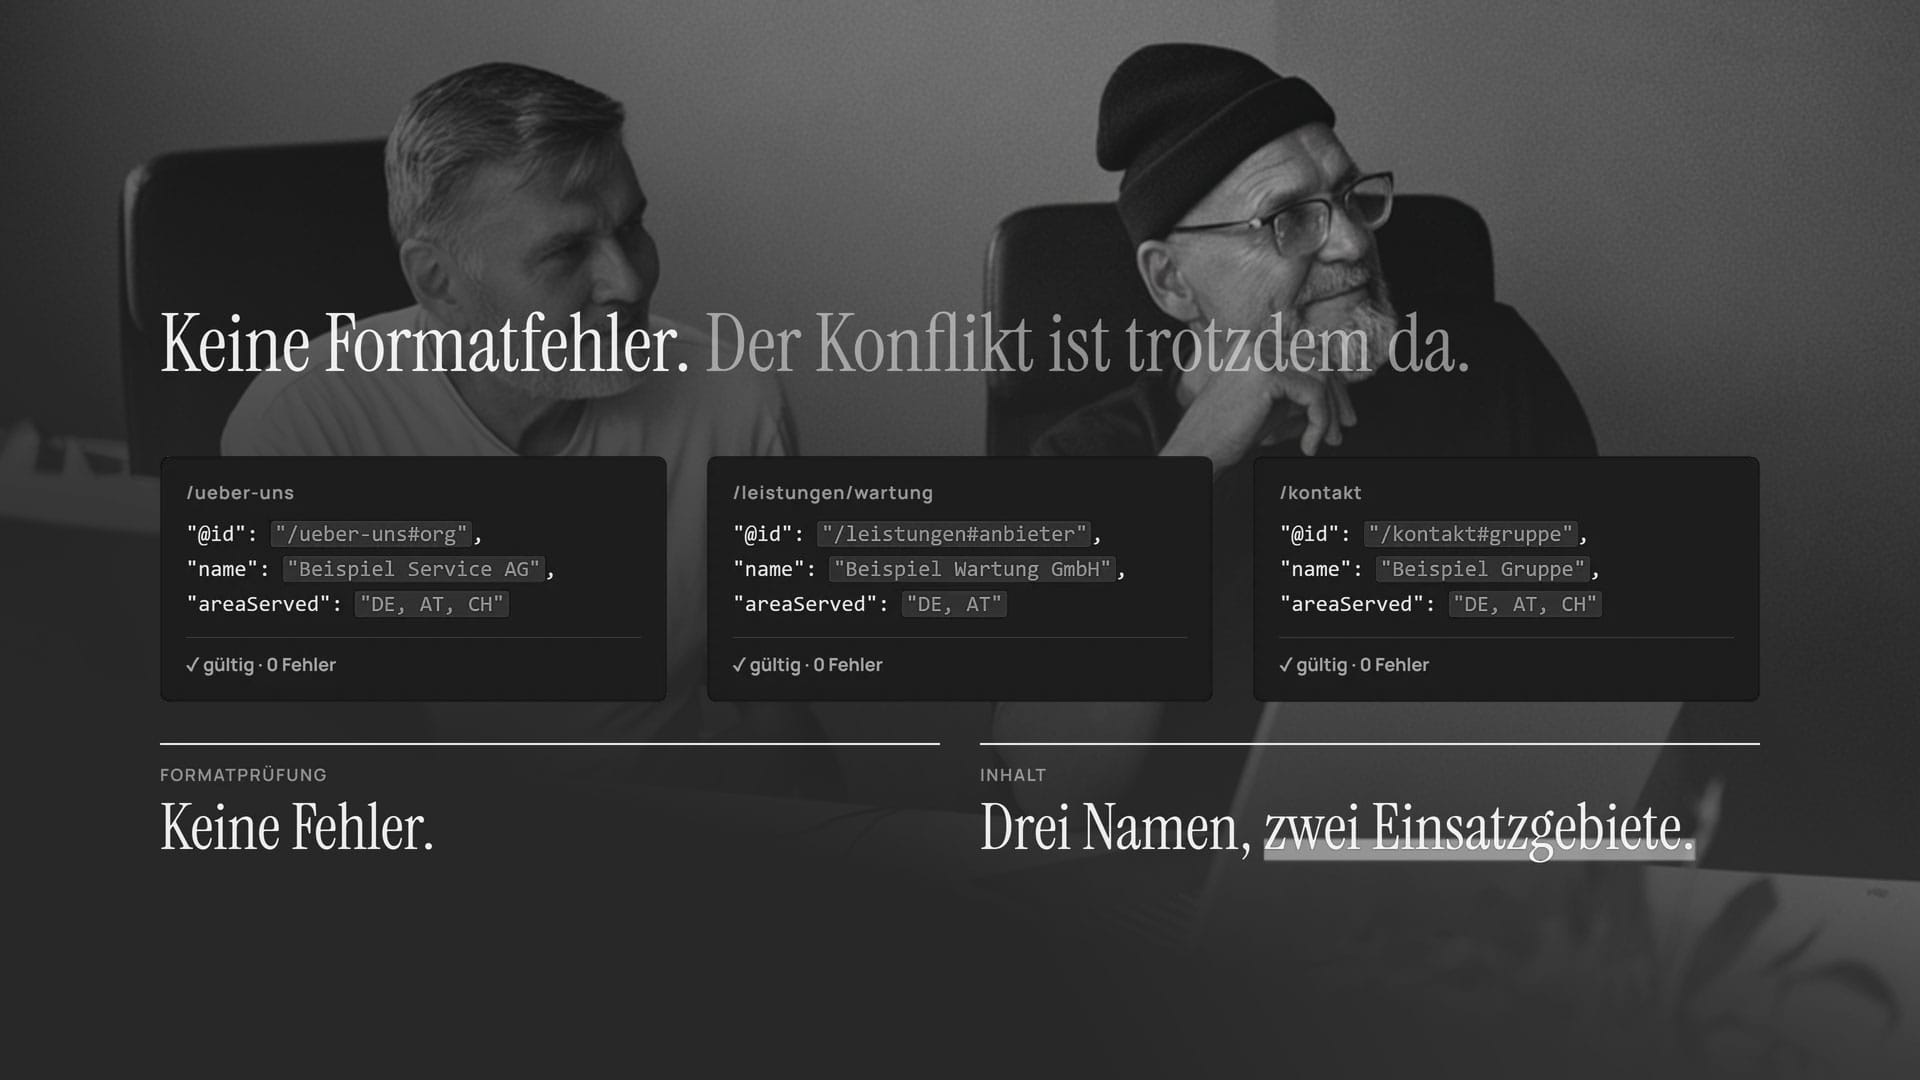
Prüfwerkzeuge für strukturierte Daten achten vor allem darauf, ob die Pflichtfelder für die Darstellung in Suchergebnissen vorhanden sind. Ob die Aussagen stimmen und zusammenpassen, prüfen sie nicht. In unseren Audits stoßen wir deshalb regelmäßig auf Daten, die jede Formatprüfung bestehen und trotzdem Ungeklärtes als Tatsache veröffentlichen.
Darum lohnt die Frage: Welche Risiken entstehen, wenn jede Seite ihre Daten selbst erzeugt? Die acht Punkte stammen aus der Gegenüberstellung, die wir in einem Audit entwickelt haben und seither verwenden. Die Beispiele sind verallgemeinert oder nachgebildet.
1. Identitätsdrift
Ein Angebot zerfällt in Kennungen, die nicht erklären, was zusammengehört: Auf verschiedenen Seitentypen trägt es jeweils eigene Kennungen. Ob es dasselbe Angebot, eine Variante oder eine eigene Leistung ist, muss die KI rekonstruieren. Domainbasiert werden Identitäten und Beziehungen zentral vergeben.
2. Ungeklärte Zahlen werden strukturierte Fakten
Eine Seite nennt im Text «über 40», in den FAQ «25» – und die strukturierten Daten führen 25 als feste Aussage. Die Formatprüfung meldet keinen Fehler, weil das Format stimmt. Domainbasiert kommt die Entscheidung zuerst, die Veröffentlichung danach.
3. Ein ungeklärter Datensatz erreicht die ganze Domain
Ein zentraler Datensatz ist der richtige Mechanismus – solange sein Inhalt stimmt. Enthält er eine veraltete Beschreibung oder eine fremde Kontaktadresse, verteilt er sie auf jede Seite. Domainbasiert wird der Datensatz hinter einer zentralen Kennung zuerst geprüft und freigegeben.
4. Parallele Beschreibungen
Besucher lesen «Lieferung in 48 Stunden für Lagerware», die FAQ-Antworten in den strukturierten Daten sagen «Lieferung in 48 Stunden». Braucht ein Käufer eine Sonderanfertigung, hängt die Auswahl genau an dieser Einschränkung. Domainbasiert lesen Menschen und Maschinen dieselbe freigegebene Aussage.

Illustration: Drei Seiten, drei Namen, zwei Einsatzgebiete – und keine einzige Fehlermeldung der Formatprüfung.
5. Alte und aktuelle Zahlen werden vermischt
Eine ältere Meldung nennt eine Kundenzahl, eine neuere eine andere, eine dritte wieder eine andere – ohne erklärte Zählweise. Eine KI gibt dann womöglich die älteste Zahl im Präsens wieder. Domainbasiert bleiben Verlauf und aktueller Wert unterscheidbar.
6. Abgerissene Geschichte
Der Text erzählt, dass ein Produkt umbenannt wurde. Die Produktdaten führen den früheren Namen aber nicht als früheren Namen. Die Verbindung zwischen alt und neu muss aus Text und alten Seiten rekonstruiert werden. Domainbasiert bleiben frühere Namen und Vorgänger den richtigen Einträgen zugeordnet.
7. Andere schreiben Ihre Geschichte
Wo Ihre Domain zu Eigentümerschaft, Herkunft und Beziehungen schweigt, füllen fremde Quellen die Lücke: Verzeichnisse, Fremdberichte, im Vergleich auch andere Anbieter. Domainbasiert nennt Ihre Domain ihre Kernfakten selbst.
8. Veröffentlichungsdrift
Ein Vorlagenfehler wiederholt sich über viele Seiten – etwa einer, durch den mehrere Referenzseiten dieselbe Kennung tragen. Domainbasiert stammen Kennungen aus einem Bestand und werden vor der Veröffentlichung geprüft.
Ein neuntes Risiko, das auch wir haben
Domainbasierte Daten lösen die acht Risiken, aber sie haben ein eigenes. Bei einem Unternehmen wurden die Standorte in der Fußzeile geändert, die strukturierten Daten nicht. Plötzlich sagten Text und Daten wieder Verschiedenes – diesmal nicht, weil jede Seite ihre eigenen Daten erzeugte, sondern weil der gemeinsame Bestand nicht mitgezogen war. Norbert Kathriner hat das ohne Umschweife benannt: «Das ist ein Nachteil von Aivis-OS.»
Daraus ist eine Anforderung an unsere eigene Software geworden: Der Wächter, der Abweichungen meldet, muss gegen die Live-Seite prüfen, nicht nur gegen den Bestand. Was domainbasierte Daten leisten, wenn die Fakten geklärt sind und gepflegt bleiben, beschreibt der Artikel «Domainbasierte strukturierte Daten: acht Vorteile».
Fazit
Gültig heißt nicht geklärt. Seitenweise erzeugte Daten können formal fehlerfrei sein und trotzdem Ungeklärtes, Veraltetes und Widersprüchliches als Tatsache veröffentlichen. Domainbasierte Daten setzen die Entscheidung vor die Veröffentlichung. Und sie brauchen jemanden, der hinschaut, wenn sich die Welt ändert – auch bei uns.
Weitere Artikel

In der ersten Antwort genannt, in der letzten nicht mehr
Warum KI-Monitoring nach der ersten Frage aufhört

Bekannt oder geeignet: Was etablierte Unternehmen und Spezialisten unterscheidet
Wenn strukturierte Daten Widersprüche veröffentlichen
Wer spricht? Was Maschinen heute von Ihrer Website lernen
Erst die Quelle, dann das Echo
Ihre Leute entscheiden. Sie tippen nicht.
Domainbasierte strukturierte Daten: acht Vorteile
Abnahme statt Bericht: Ziel, Grenze und Abschluss
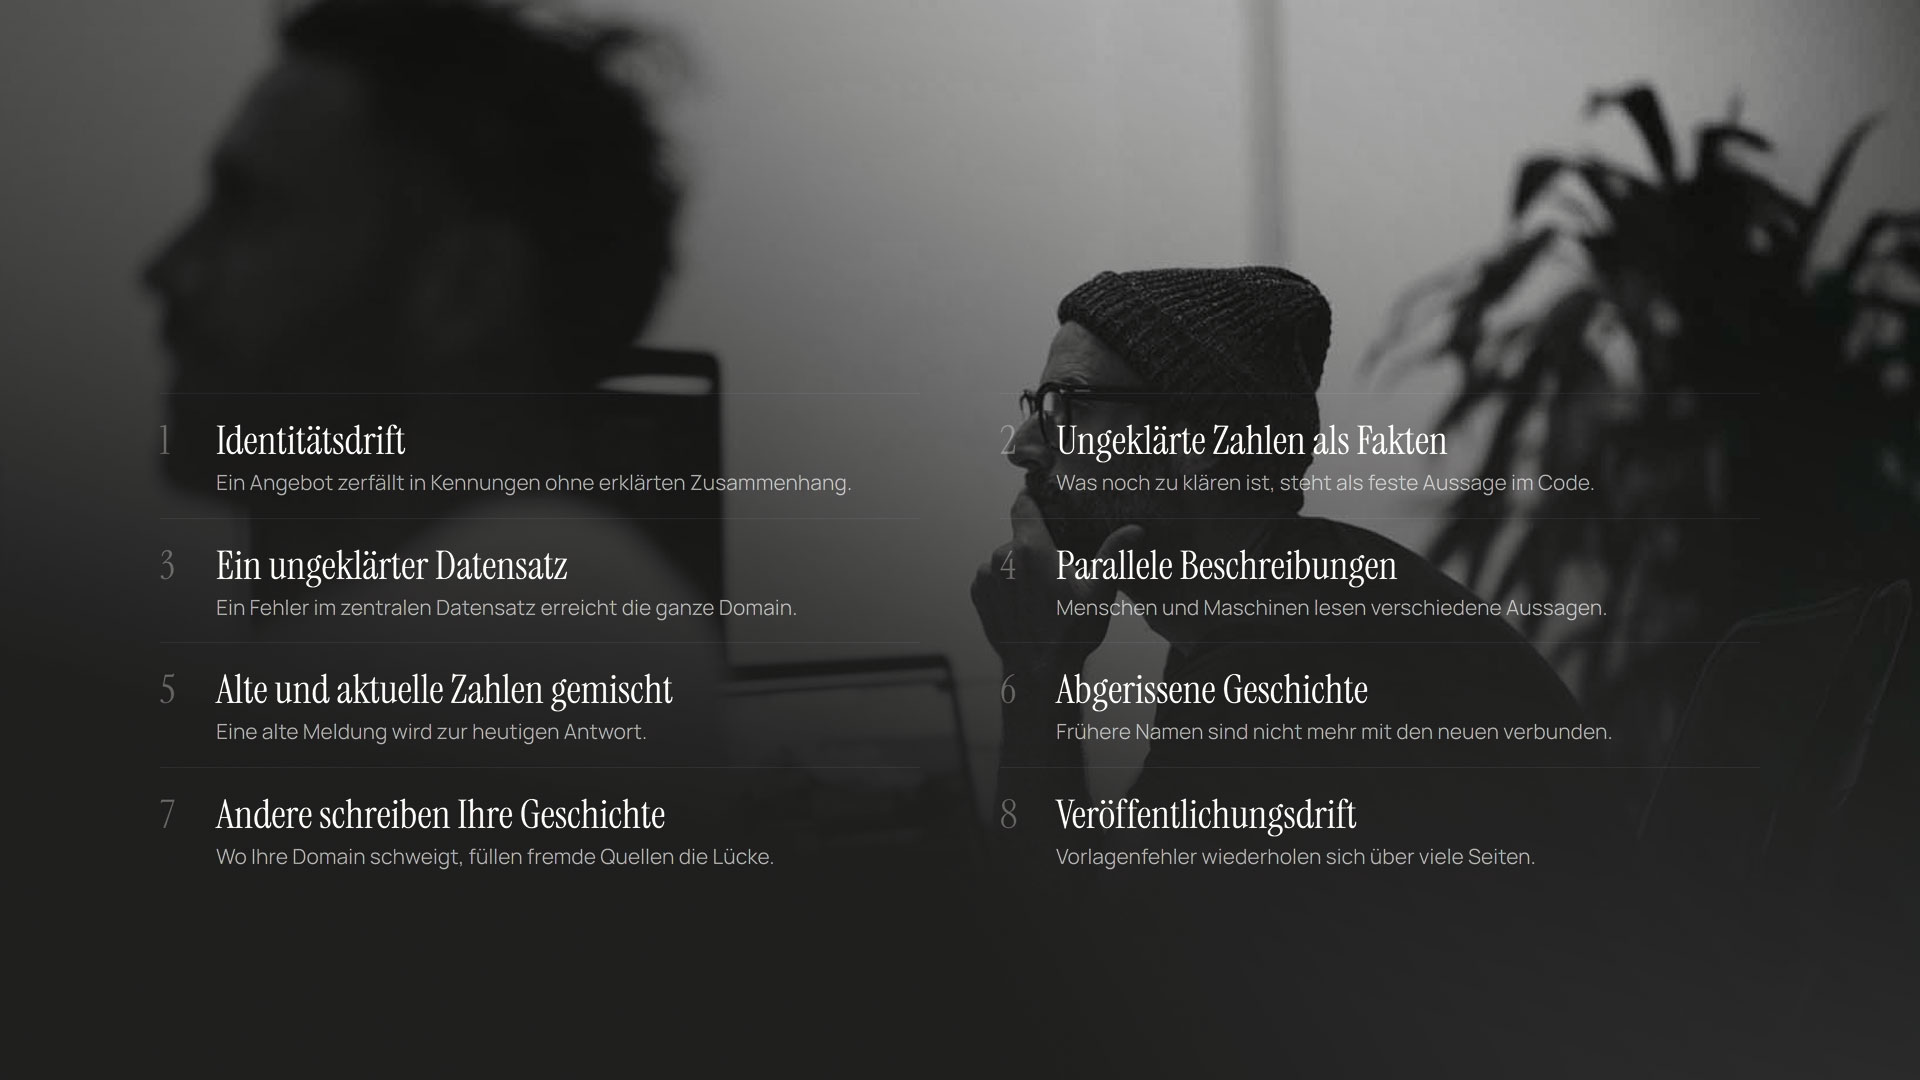
Seitenweise erzeugte Daten: acht Risiken
FAQ
Woran erkenne ich, ob meine Daten betroffen sind?
Eine Formatprüfung zeigt es nicht. Nötig ist ein Abgleich der strukturierten Daten mit dem sichtbaren Text und untereinander. Das Kompaktaudit zählt solche Konfliktgruppen auf einer Auswahl Ihrer Seiten.
Sind diese Risiken selten?
Sie entstehen leicht, wenn Websites über Jahre wachsen, umbenannt werden oder mehrere Gesellschaften abbilden. Wie häufig sie auf Ihrer Domain sind, zeigt erst ein Abgleich.
Haben domainbasierte Daten keine Risiken?
Doch: Wenn sich der sichtbare Text ändert und der gemeinsame Bestand nicht mitzieht, entsteht wieder eine Abweichung. Deshalb muss die Überwachung gegen die Live-Seite prüfen.
Kontaktieren Sie uns, um Ihr Projekt zu besprechen oder einfach nur unsere Meinung einzuholen.